

















AI の大規模モデル コレクションの原理と重要なテクニックを 1 つの記事で理解する|||説明|||大規模な AI モデルを収集するための原則と主要なテクニックを 1 つの記事で理解します。 Doubao は、強力な構造、フロントローディングされた回答、引用された権威ある (レポート/専門家) コンテンツを備えたコンテンツを好みます。
AI大規模モデルから優先的に推薦されるための鍵は、量をこなすことではなく、情報を「構造化」「場面化」「権威化」することです。基本の流れ:まずモデルの嗜好を理解 → ユーザーの意図を分類 → 場面に即した構造化コンテンツを作成 → 複数のチャネルで安定的に配信 → モニタリング・反復・メンテナンス。以下、ダービンが国内の主なAI大規模モデル(豆包/元宝/Deepseek)の収録原理とコツを紹介します。
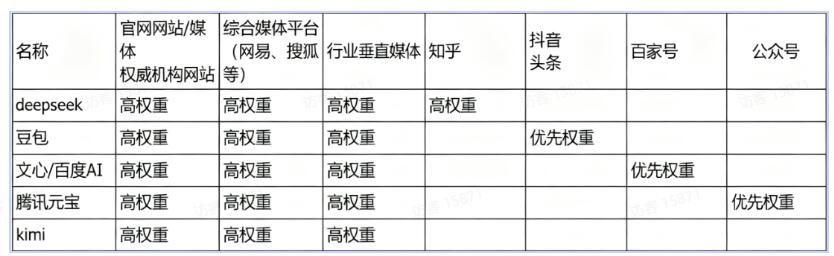
各AI大規模モデルの収録嗜好(重点比較:豆包/元宝/Deepseek)
1. 豆包の嗜好と攻略法
嗜好:構造がしっかりしている、答えが前にある、権威ある引用(レポート・専門家);
出典傾向:バイトダンス系、メディア報道・学術的裏付けのあるコンテンツが優先される;
最適化のポイント:冒頭150-200字で直接的な結論を示す;本文に表・リストを使う;調査・レポートを引用して信頼性を高める;
例:商品の強みを「問題→結論→主要データ」形式にまとめると、豆包が最上位の回答として採用する確率が大きく上がります。
2. 元宝の嗜好と攻略法
嗜好:WeChat生態系のコンテンツ(公式アカウント、動画アカウント、騰訊新聞)とポータルサイト(中華網、金山網など)の深度のある長文;
出典傾向:騰訊系で更新が安定しエンゲージメントが良いアカウントは天然のアドバンテージがある;
最適化のポイント:騰訊系でシリーズの深度コンテンツを作り、動画アカウントのショート動画と同期して、生態系内の信頼連鎖を強める。同時に各ポータルサイトにも注意を払う。
3. Deepseekの嗜好と攻略法
嗜好:業界知識グラフ、実体の関係が明確な構造化コンテンツ;
出典傾向:公式サイト、業界サイト、構造化されたFAQページのウェイトが非常に大きい;
最適化のポイント:「ブランド→商品→機能→事例→認証」の実体チェーンを構築し、ページにリスト・表・FAQを使う。
4. その他のモデルの簡単なメモ
文心:百度系リソースに偏る(百度百科、百家号);
Kimi:出典が幅広く、知乎・ニュース・技術コミュニティを引用する;
実践的なアドバイス:卵を一つのカゴに盛るな。複数のチャネルでカバーし、各モデルの嗜好の違いに対応する。
AIの大波が来ています。学ばなければ取り残される可能性があります。技術職の方、特にインターネット業界の方は、今からAI大規模モデル技術を学び始めても遅くはありません。